Пересказ статьи gbargsley. Beyond VARBINARY: How to Store PDFs in SQL Server Using FILESTREAM and FileTable
Сегодня мы поговорим о теме, которая возникает чаще, чем вы думаете: хранение PDF-документов внутри SQL Server.
Будут ли это счета, отчеты, отсканированные формы или контракты, приложениям часто нужно где-то хранить файлы. Вы могли бы хранить их в общей сетевой папке и надеяться, что ничто не повредит ссылку, или вы можете полностью перенести их в SQL Server, где они будут находиться вместе с вашими данными. В этой статье я собираюсь рассказать вам о настройке
FILESTREAM и FileTable в SQL Server, средствах, которые дают вам лучшее из двух миров: транзакционная целостность от SQL Server и производительность файловой системы от NTFS.
Continue reading "За пределами VARBINARY: как сохранить PDF в SQL Server, используя FILESTREAM и FileTable"
Пересказ статьи Brent Ozar. How Multi-Column Statistics Work
Краткий ответ: в реальных ситуациях работает только первый столбец. Когда SQL Server необходимы данные о втором столбце, он строит вместо этого свою собственную статистику по этому столбцу (предполагая, что ее не существует) и использует эти две статистики совместно - но на самом деле они не связаны.
Чтобы дать более подробный ответ, давайте возьмем большую версию
базы данных Stack Overflow, создадим двухстолбцовый индекс на таблице Users, а затем посмотрим на полученную статистику:
DropIndexes;

GO

CREATE INDEX Location_Reputation

    ON dbo.Users(Location, Reputation);

GO

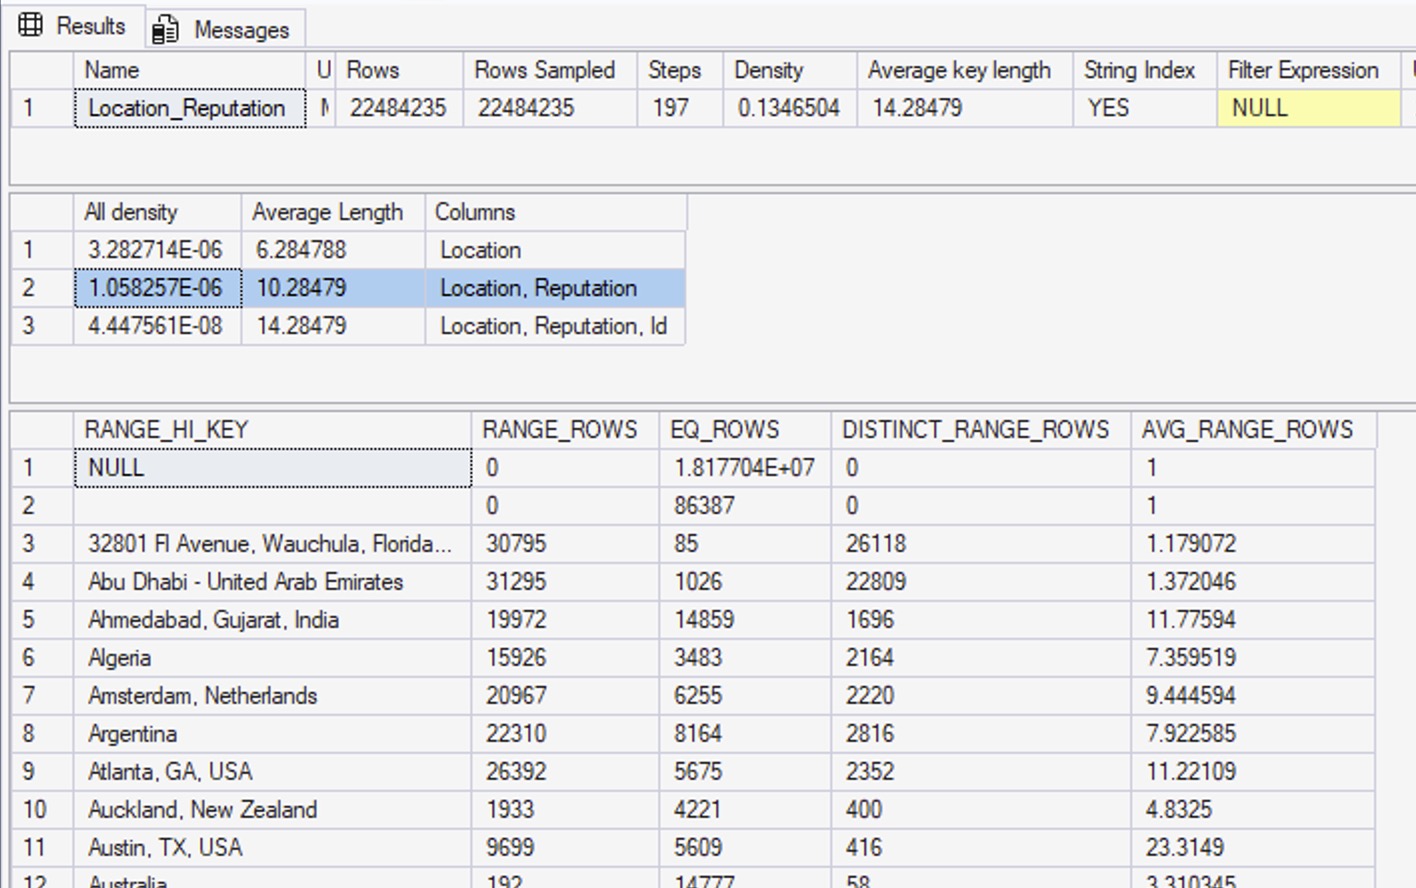
DBCC SHOW_STATISTICS('dbo.Users', 'Location_Reputation');

GO
Вывод DBCC SHOW_STATISTICS показывает, что мы получили 22 миллиона строк в этой таблице. Итак, что гистограмма статистики говорит нам о связи между locations и reputations?
 Continue reading "Как работает многостолбцовая статистика"
Пересказ статьи rebecca@sqlfingers. CONVERT_IMPLICIT: Why SQL Server Is Ignoring Your Index
Вы построили индекс и протестировали запрос в SSMS. Index seek. Идеально. Вы пошли домой.
Между тем ваше приложение сканировало каждую строку в этой таблице, начиная со дня его запуска.
Это CONVERT_IMPLICIT - один из наиболее скрытых убийц производительности в SQL Server. Никаких ошибок. Никаких предупреждений в журнале приложения. Запрос возвращает правильные результаты, а ваш индекс отлично структурирован, но оптимизатор его не использует, поскольку тип данных, приходящих из приложения, не соответствует типу данных столбца - и SQL Server должен преобразовывать каждую строку, прежде чем он сможет выполнить сравнение.
Здесь рассказывается, как найти, понять и доказать разработчику, который продолжает говорить вам, что "все прекрасно работает на моей машине".
Continue reading "CONVERT_IMPLICIT: Почему SQL Server игнорирует ваш индекс"
Пересказ статьи Deepak Vohra. Why use a Composite Index in SQL Server
Запросы SQL могут выполняться долго, особенно на больших таблицах, при отсутствии надлежащего индексирования. Полное сканирование таблицы может быть затратной операцией, когда все, чего хочет пользователь, - это извлечь небольшое число строк на основе нескольких столбцов и фильтра WHERE. Как правильно проиндексировать наши таблицы для поддержки запросов по нескольким столбцам?
В этой статье я объясню, как использовать составной индекс для уменьшения стоимости тех запросов, которые используют фильтрацию по всем столбцам или по подмножеству столбцов. Уменьшение стоимости означает более быстрый запрос.
Не существует специальной настройки, требуемой для использования составных индексов. SQL Server поддерживает составные индексы. Для демонстрации функциональности я использую SQL Server 2022, исполняемый на Windows 10, с SQL Server Management Studio (SSMS) 2022.
Continue reading "Зачем использовать составной индекс в SQL Server"