Skip to content

Как работают пользовательские типы в PostgreSQL: полное руководство

Пересказ статьи Grant Fritchey. How User-Defined Types work in PostgreSQL: a complete guide


Узнайте, как работать с определяемыми пользователем типами в PostgreSQL, в том числе как эффективно их определять, использовать и управлять ими. В этом руководстве объясняется, как пользовательские типы могут улучшить проектирование схемы, усилить целостность данных и поддерживать более ясные и более удобные в обслуживании структуры баз данных в реальных приложениях.

Я уверен, что не одинок, когда говорю: иногда я отвлекаюсь. В данном конкретном случае я не собирался изучать пользовательские типы (UDT) в PostgreSQL — я просто хотел протестировать поведение, связанное с созданием UDT. Но как только я начал читать, меня зацепило. Я имею в виду четыре разных UDT с разным поведением. Это очень круто. Давайте займемся этим.
Continue reading "Как работают пользовательские типы в PostgreSQL: полное руководство"

Новости за 2026-09-05 - 2026-09-11

§ Новая задача от Pegoopik (1 балл) выставлена для обсуждения под номером 303.

§ Популярные темы недели на форуме

Топик		Сообщений	Просмотров
58 (Learn) 6 6
207 (SELECT) 2 4
53 (Learn) 2 6

§ Авторы недели на форуме

Автор		Сообщений
Steamboat 3
Murderface_ 3
Demon_gr 2
pegoopik 2
selber 2
Continue reading "Новости за 2026-09-05 - 2026-09-11"

Почему SUM после JOIN завышает итог — и почему DISTINCT не всегда помогает

Автор Глеб Зайцев


В отчёте два оплаченных заказа на 1 600 рублей, а запрос возвращает 2 600. Синтаксис правильный, ошибок выполнения нет. Причина может быть в том, что после соединения таблиц одна и та же сумма заказа встречается несколько раз.

Разберём этот случай на маленькой базе SQLite и проверим исправление не только на удачном примере, но и на пограничных данных. Для запуска полного скрипта в конце статьи нужны Python 3 и встроенный модуль `sqlite3`. Внешняя база, аккаунт и дополнительные пакеты не требуются.
Continue reading "Почему SUM после JOIN завышает итог — и почему DISTINCT не всегда помогает"

Всё о GUC по порядку: hash_mem_multiplier

Автор Christophe Pettus: All Your GUCs in a Row: hash_mem_multiplier


Сортировки и хэш-операции имеют разное отношение к памяти, и этот параметр существует потому, что PostgreSQL большую часть своей истории делал вид, что это не так.


hash_mem_multiplier — это значение с плавающей точкой, по умолчанию 2.0, контекст — пользовательский, диапазон от 1.0 до 1000. Что он делает, легко сформулировать: операциям на основе хэширования разрешено использовать work_mem, умноженный на это значение, в то время как операции на основе сортировки получают обычный work_mem. При значениях по умолчанию сортировка может использовать 4 МБ, прежде чем сбросить данные на диск, а хэш-таблица может использовать 8 МБ. Под хэш-таблицами здесь понимаются те, что стоят за хэш-соединениями, хэш-агрегацией, узлами memoize и хэш-обработкой подзапросов IN.

Continue reading "Всё о GUC по порядку: hash_mem_multiplier"

Всё о GUC по порядку: gss_accept_delegation

Автор Christophe Pettus: All Your GUCs in a Row: gss_accept_delegation


gss_accept_delegation — это логический параметр, по умолчанию выключен, его контекст — sighup. Он управляет тем, будет ли ваш сервер PostgreSQL принимать учётные данные Kerberos, которые передаёт ему клиент, и причина, по которой он по умолчанию выключен, заключается в том, что принятие этих данных означает, что сервер сможет затем действовать от имени этого пользователя по отношению к другим системам. Это один из тех параметров, где значение по умолчанию является безопасным выбором, а его включение — это сознательное решение принять на себя риск в обмен на определённую возможность. Поэтому полезное, что может сделать эта статья, — это объяснить саму возможность, риск и то, как определить, действительно ли вы хотите этот обмен.

Continue reading "Всё о GUC по порядку: gss_accept_delegation"

Всё о GUC по порядку: gin_fuzzy_search_limit

Автор Christophe Pettus: All Your GUCs in a Row: gin_fuzzy_search_limit


Это название вводит в заблуждение сразу дважды. Параметр никак не связан с нечётким сопоставлением, то есть с поиском по триграммному сходству или близости написания, ради которого обычно обращаются к pg_trgm. И это на самом деле не совсем ограничение поиска. Неопределённость заключается в размере набора результатов: этот параметр фактически велит PostgreSQL вернуть меньше строк, чем соответствует вашему запросу, причём выбранных случайным образом, и ничего вам об этом не сообщить.


Из-за этого параметр почти уникален среди GUC. Многие параметры позволяют обменивать один ресурс на другой, а некоторые жертвуют надёжностью ради скорости. Этот же жертвует корректностью ради скорости.


Целочисленный параметр, по умолчанию 0, что означает отсутствие ограничения; контекст user, допустимое значение — до 2147483647.

Continue reading "Всё о GUC по порядку: gin_fuzzy_search_limit"

Всё о GUC по порядку: семейство geqo

Christophe Pettus: All Your GUCs in a Row: The geqo Family


Семь параметров, одна функция и разумная цель — никогда не использовать ни один из них.


geqo, geqo_threshold, geqo_effort, geqo_pool_size, geqo_generations, geqo_selection_bias и geqo_seed — все они настраивают Генетический оптимизатор запросов (Genetic Query Optimizer), альтернативный поиск порядка соединений, к которому PostgreSQL прибегает, когда в запросе слишком много отношений для полного перебора обычным планировщиком. Все семь параметров имеют контекст user, поэтому любой из них можно установить для сессии, роли или базы данных.


Причина рассматривать их как группу в том, что шесть из семи имеют значение только в том случае, если вы уже «проиграли». Тот, который имеет значение, — это geqo_threshold, и он определяет, вступают ли в игру остальные шесть вообще.

Continue reading "Всё о GUC по порядку: семейство geqo"

Как работает многостолбцовая статистика

Пересказ статьи Brent Ozar. How Multi-Column Statistics Work


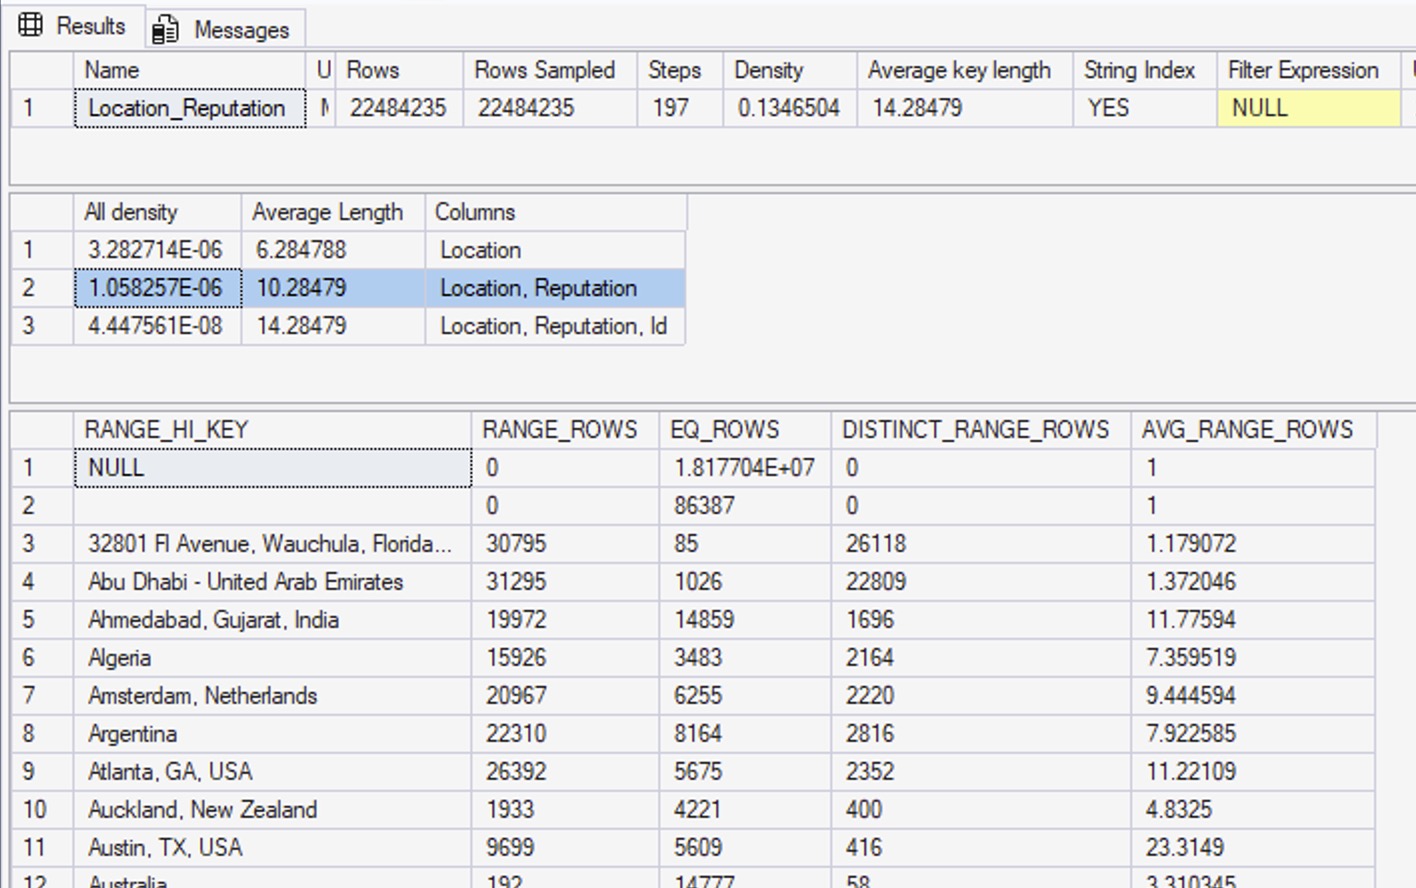
Краткий ответ: в реальных ситуациях работает только первый столбец. Когда SQL Server необходимы данные о втором столбце, он строит вместо этого свою собственную статистику по этому столбцу (предполагая, что ее не существует) и использует эти две статистики совместно - но на самом деле они не связаны.

Чтобы дать более подробный ответ, давайте возьмем большую версию базы данных Stack Overflow, создадим двухстолбцовый индекс на таблице Users, а затем посмотрим на полученную статистику:

DropIndexes;
GO
CREATE INDEX Location_Reputation
ON dbo.Users(Location, Reputation);
GO
DBCC SHOW_STATISTICS('dbo.Users', 'Location_Reputation');
GO

Вывод DBCC SHOW_STATISTICS показывает, что мы получили 22 миллиона строк в этой таблице. Итак, что гистограмма статистики говорит нам о связи между locations и reputations?


Continue reading "Как работает многостолбцовая статистика"

MVCC в PostgreSQL — это плохо, как и у других

Radim Marek: PostgreSQL's MVCC is bad. So is everyone else's


Первое, что вы, вероятно, узнаете о Postgres, если следите за людьми, которым он не нравится, — это то, что MVCC — это плохо. Ошибка дизайна сорокалетней давности. Её признаки повсюду: раздутые таблицы, удваивающиеся в размере, 32-битный лимит счётчика транзакций, бесконечная борьба с VACUUM, кошмары с мёртвыми кортежами. Это подтверждается и авторитетами: Uber измерил амплификацию (здесь - усиление) записи в 2016 году и ушёл на MySQL из-за этого; группа баз данных Энди Павло назвала MVCC частью PostgreSQL, которую они ненавидят больше всего. Это реально. Postgres настолько плох, насколько это возможно.


Хотя всё это не преувеличено, это сводится к реальному дизайнерскому выбору. Раздувание, амплифицированные записи, постоянный уход за VACUUM — все эти обвинения связаны с решением, а не с дефектом, и мы воспроизводим каждое из них ниже на живом экземпляре PostgreSQL 19 beta2, чтобы вы могли увидеть ущерб своими глазами. Но вердикт, который распространяется из сообщества в сообщество, всегда останавливается на один вопрос раньше: по сравнению с чем? Что вместо этого делают все другие движки, и во что это обходится?


Потому что MVCC не является опциональным. Любая база данных, которая хочет, чтобы читатели не блокировали писателей, должна где-то хранить несколько версий строк, и каждый движок, который это делает, отвечает на одни и те же четыре вопроса:


  1. Где живут старые версии? В самой таблице или в отдельной структуре?

  2. В каком направлении указывают цепочки версий? От старых к новым или от новых к старым?

  3. На что указывают индексы? На физическое расположение строки или на логический ключ?

  4. Кто выполняет очистку и когда? Фоновый процесс позже или сама транзакция?


Ответы PostgreSQL: в таблице, от старых к новым, физическое расположение, фоновый процесс позже. Каждая стоимость, которую перечисляют критики, следует из этих четырёх ответов. И каждая альтернатива — это другой набор ответов, где счёт выставляется кому-то другому: писателю, читателю истории, tempdb, кэшу, компактору. Одна из них потратила годы инженерной работы, чтобы купить одно свойство, которое дизайн PostgreSQL имел бесплатно с первого дня. Все они терпят неудачу по-разному, когда транзакция остаётся открытой во время обеда...

Continue reading "MVCC в PostgreSQL — это плохо, как и у других"
Всё о GUC по порядку: full_page_writes

Автор Christophe Pettus: All Your GUCs in a Row: full_page_writes


full_page_writes — это логический параметр, по умолчанию включён, его контекст — sighup, устанавливается в postgresql.conf или в командной строке. Это причина, по которой аварийное восстановление вообще работает, и это также причина, по которой ваш график WAL имеет «пилообразную» форму.

Continue reading "Всё о GUC по порядку: full_page_writes"

CONVERT_IMPLICIT: Почему SQL Server игнорирует ваш индекс

Пересказ статьи rebecca@sqlfingers. CONVERT_IMPLICIT: Why SQL Server Is Ignoring Your Index


Вы построили индекс и протестировали запрос в SSMS. Index seek. Идеально. Вы пошли домой.

Между тем ваше приложение сканировало каждую строку в этой таблице, начиная со дня его запуска.

Это CONVERT_IMPLICIT - один из наиболее скрытых убийц производительности в SQL Server. Никаких ошибок. Никаких предупреждений в журнале приложения. Запрос возвращает правильные результаты, а ваш индекс отлично структурирован, но оптимизатор его не использует, поскольку тип данных, приходящих из приложения, не соответствует типу данных столбца - и SQL Server должен преобразовывать каждую строку, прежде чем он сможет выполнить сравнение.

Здесь рассказывается, как найти, понять и доказать разработчику, который продолжает говорить вам, что "все прекрасно работает на моей машине". Continue reading "CONVERT_IMPLICIT: Почему SQL Server игнорирует ваш индекс"

Новости за 2026-08-29 - 2026-09-04

§ Лидеры недели

	Участник		w_sel	all_sel	select	dml	Всего	Рейтинг
Цыбин А.В. (magicdragon) 4 38 11 3 14 1524
Шибаев (saah) 4 90 9 0 9 537
Скоков Б.С. (leks$$) 4 48 8 0 8 1097
Виноградова С.М. (Tigra1) 2 154 7 0 7 148
Powkh N.M. (I_AiLL_I) 4 4 5 21 26 4141

§ Претенденты на попадание в TOP 100

Рейтинг	 Участник (решенные задачи, время в днях)
148 Tigra1 (154, 31.674)
Continue reading "Новости за 2026-08-29 - 2026-09-04"

Правильный способ предоставить доступ к вашей базе данных PostgreSQL стороннему администратору

SHRIDHAR KHANAL: The Right Way to Give a Third-Party DBA Access to Your PostgreSQL Database


Предоставление доступа к вашей базе данных PostgreSQL внешней команде — это решение, которое заслуживает некоторого обдумывания. Самый простой вариант — передать учётную запись суперпользователя, но это редко бывает правильным. Лучший подход — создать выделенную роль только с теми привилегиями, которые им действительно нужны, и это займёт всего несколько минут.


За эти годы я был по обе стороны этого разговора. Я был внешним администратором, которого подключали к базе данных клиента, и я был внутренним инженером, решающим, какой доступ предоставить. Шаблон, который я собираюсь вам показать, — это тот, к которому я бы прибег в любой из этих ситуаций: специально созданная, не-суперпользовательская роль, которая даёт внешней команде ровно то, что им нужно для реальной работы, и ничего лишнего.

Continue reading "Правильный способ предоставить доступ к вашей базе данных PostgreSQL стороннему администратору"

Всё о GUC по порядку: fsync

Christophe Pettus: All Your GUCs in a Row: fsync


fsync — это логический параметр, по умолчанию включён, его контекст — sighup, поэтому его можно изменить перезагрузкой конфигурации без перезапуска. Это также самая опасная настройка в postgresql.conf. Большинство параметров из этой серии при неправильной установке стоят вам плохого плана или некоторой потраченной впустую памяти. Этот же параметр при неправильной установке стоит вам кластера.


Continue reading "Всё о GUC по порядку: fsync"

GIN-индексы в PostgreSQL

Автор: Klaus Aschenbrenner: GIN Indexes in PostgreSQL


Если вы пришли из SQL Server (как в моём случае), индексы PostgreSQL могут показаться сначала знакомыми — существуют B-tree индексы, составные индексы, покрывающие индексы. А затем вы сталкиваетесь с запросами вроде:


WHERE payload @> '{"type":"payment","status":"failed"}'


или:


WHERE tsv @@ plainto_tsquery('postgresql')


В этот момент большинство разработчиков SQL Server задают два вопроса:


  1. Что это за операторы?

  2. Почему для этого PostgreSQL требуется совершенно другой тип индекса?


Continue reading "GIN-индексы в PostgreSQL"