Пересказ статьи Pradip Kharal. Full text search in postgresql
Полнотекстовый поиск или просто поиск текста - это процесс идентификации документов на естественном языке, которые удовлетворяют запросу, с дополнительной возможностью их сортировки по релевантности запросу. Хотя PostgreSQL содержит операторы ~, ~*, LIKE и ILIKE для текстовых типов данных, они не обладают многими существенными возможностями, а именно:
- Отсутствует лингвистическая поддержка.
- Не поддерживается упорядоченность результатов поиска.
- В целом выполняются медленно, т.к. отсутствует поддержка индексов.
Полнотекстовый индекс позволяет проиндексировать документы, поэтому мы можем быстро выполнять поиск текста. Этот процесс включает:
- Разбивка документов на токены.
- Преобразование токенов в лексемы.
- Хранение предварительно обработанных документов в оптимизированной для поиска форме.
Continue reading "Полнотекстовый поиск в PostgreSQL"
Пересказ статьи Venky Rao. Postgresql: The simplicity
Предложение DISTINCT ON в PostgreSQL действительно является мощным средством для выборки уникальных записей на базе указанных столбцов. Давайте исследуем эту функциональность, используя учебную базу данных Northwind, и сравним ее с подходами в Oracle и SQL Server.
PostgreSQL DISTINCT ON
Для нахождения последнего заказа для каждого заказчика в базе данных Northwind, используя PostgreSQL:
SELECT DISTINCT ON (customer_id) customer_id, order_id, order_date

FROM orders

ORDER BY customer_id, order_date DESC;
Этот запрос извлекает самый последний заказ для каждого заказчика, упорядоченных по customer_id и order_date в убывающем порядке.
Continue reading "PostgreSQL: простота"
Пересказ статьи Sudheer Gajula. PostgreSQL Async-IO using io_uring
Вышла бета-версия PostgreSQL 18.1, в которой появился асинхронный ввод-вывод, позволяющий увеличить его пропускную способность.
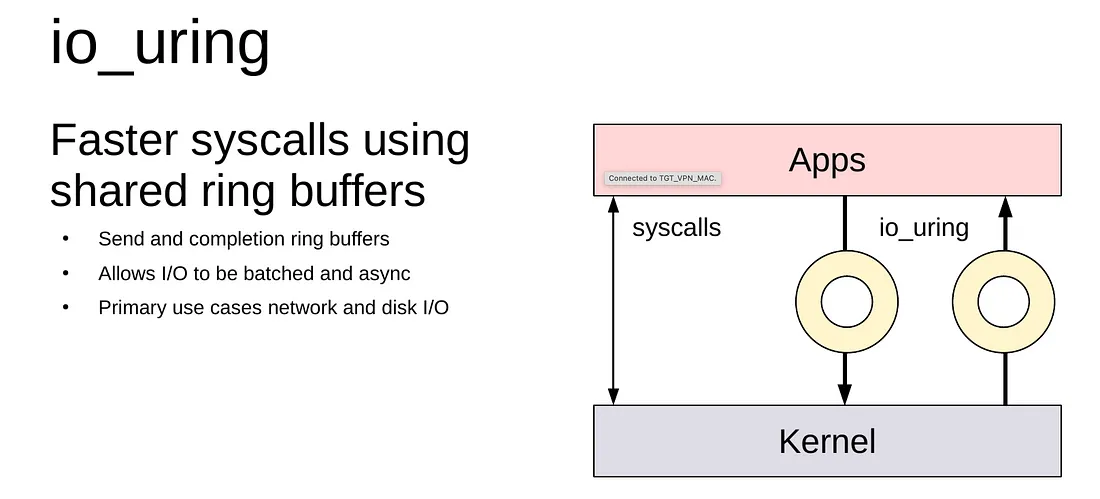
io_uring в linux поддерживает асинхронный ввод-вывод посредством разделяемых кольцевых буферов для принятия и выполнения задач.
io_uring
Ядро Linux имеет асинхронный интерфейс ввода-вывода, который называется io_uring. Два кольцевых буфера в разделяемой памяти, которые служат очередями между пространством пользователя и ядром, называются io_uring.
Очередь подачи заявок (SQ): асинхронные запросы ввода-вывода посылаются ядру пользовательским процессом посредством очереди подачи заявки.
Очередь выполнения заявок (CQ): ядро возвращает выход асинхронных операций ввода-вывода в пространство пользователя посредством очереди выполнения заявки.
 Continue reading "Использование io_uring для асинхронного ввода-вывода в PostgreSQL"
Пересказ статьи DbVisualizer. 5 Ways to Split Strings in PostgreSQL Complete Guide with Examples
Разбивка строк в PostgreSQL имеет важное значение в управлении и эффективном получении текстовых данных. PostgreSQL обладает мощными встроенными функциями, специально предназначенными для управления разбивкой строк, преобразования сложных текстов в организованные массивы или строки таблицы, тем самым упрощая манипуляцию и анализ данных.
Комплексные функции разбиения строк в PostgreSQL
1. SPLIT_PART()
Извлекает конкретные подстроки путем указания позиции после разбиения по разделителю.
-- Извлекает домен из почтового адреса

SELECT SPLIT_PART('john@example.com', '@', 2); -- 'example.com'
Идеально подходит для обработки адресов электронной почты, имен пользователей и расширений файлов.
Continue reading "5 способов разбивки строк в PostgreSQL: полное руководство с примерами"
Пересказ статьи Arief JR. Optimize Your Database Step-by-Step Guide to Setting Up pgpool-II with PostgreSQL Master-Slave Configuration And Failover Implementation
Pgpool-II является ПО промежуточного уровня, которое находится между серверами PostgreSQL и клиентом баз данных PostgreSQL, обеспечивающего такие функции, как пул подключений, балансировку нагрузки, автоматическую отказоустойчивость, кэширование запросов и многое другое. Оно действует как прокси, обслуживая и распределяя клиентские подключения по множеству серверов баз данных PostgreSQL.
Вот обзор некоторых основных функций pgpool-II:
- Пул подключений: pgpool-II поддерживает пул установленных подключений к серверам PostgreSQL, снижая накладные расходы на создание и закрытие подключений для каждого запроса клиента. Это улучшает производительность путем минимизации времени установки соединения и использования ресурсов на сервере баз данных.
- Балансировка нагрузки: Распределяет клиентские соединения по множеству серверов PostgreSQL для равномерного распределения нагрузки. Это помогает улучшить масштабирование и производительность путем задействования ресурсов нескольких серверов.
- Автоматическая отказоустойчивость: pgpool-II может обнаруживать сбои серверов PostgreSQL и автоматически перенаправлять подключения на резервные серверы в случае отказа главного сервера. Это обеспечивает высокую доступность и отказоустойчивость приложений баз данных.
- Кэширование запросов: pgpool-II может кэшировать часто выполняемые запросы и их результаты, снижая рабочую нагрузку на серверы баз данных и улучшая время отклика для повторяющихся запросов.
- Параллельное выполнение запросов: Поддерживается распараллеливание выполнения запроса, обеспечивая распределение и параллельное выполнение запросов на множестве серверов PostgreSQL для более быстрой обработки запроса.
- Сторожевой таймер: pgpool-II включает функцию сторожевого таймера, который мониторит работоспособность и состояние серверов PostgreSQL и экземпляров pgpool-II, выполняяя по мере необходимости автоматизированные действия по отказоустойчивости и восстановлению для поддержания доступности системы.
Continue reading "Оптимизируйте свою базу данных: пошаговое руководство по настройке pgpool-II с конфигурацией PostgreSQL Master-Slave и реализацией отказоустойчивости"
Пересказ статьи mohyusufz. Boosting Performance: Optimizing PostgreSQL Functions
Хорошо оптимизированные функции могут значительно улучшить эффективность базы данных. В этой статье будут даны советы и предложены методы для обеспечения наиболее эффективной работы функций в PostgreSQL.
Как функции улучшают производительность
Функции могут улучшить производительность базы данных за счет:
- Сокращение сетевой задержки: Выполнение логики на стороне сервера уменьшает необходимость пересылки больших объемов данных по сети.
- Минимизация передачи данных: Функции могут обрабатывать данные на сервере и возвращать клиенту только необходимый результат.
- Кэширование планов выполнения: PostgreSQL кэширует планы выполнения для функций, уменьшая накладные расходы на повторяющиеся парсинг и построение плана.
Continue reading "Повышение производительности: оптимизация функций PostgreSQL"