Пересказ статьи Mitchell Warr. Joining Big SQL Tables How to Load Data Fast Part 2
В
части 1 мы рассмотрели несколько методов ускорения запросов в PostgreSQL.
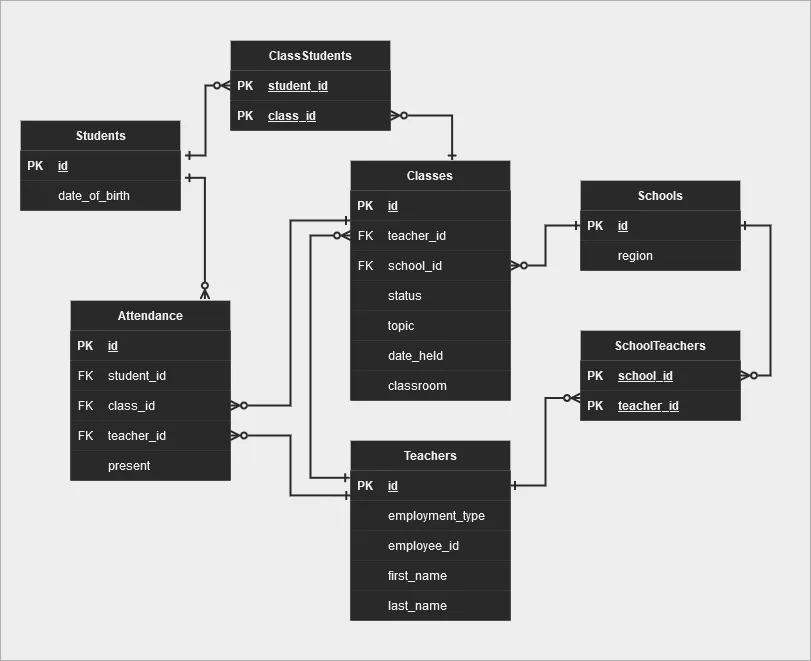
Давайте исследуем нашу собственную историю и ускорим запрос. Мы создадим набор таблиц для студентов, классов, преподавателей и посещаемости. Для нашего примера диаграмма ERD будет выглядеть как на рисунке ниже.
 Continue reading "Соединение больших таблиц в SQL. Как быстро загрузить данные: часть 2"
Пересказ статьи Andy Brownsword. Optimising DISTINCT Clauses using EXISTS
Предложение DISTINCT может помочь нам быстро убрать дубликаты из результатов запроса. Иногда полезно остановиться и спросить почему. Почему нам необходимо использовать это предложение, почему мы получаем дубликаты из наших данных?
Обычно я вижу это из-за применения JOIN, когда на самом деле нам не нужны все эти результаты. Это может быть проверка «существует ли что-либо», например, делал ли клиент когда-либо заказ раньше. Проблема возникает, когда имеется много возвращаемых строк, например, для постоянного клиента в нашем примере.
Continue reading "Оптимизация предложений DISTINCT с помощью EXISTS"
Пересказ статьи Dmitry Romanoff. PostgreSQL parameter log_min_duration_statement
log_min_duration_statement является конфигурационным параметром PostgreSQL. Он устанавливает минимальное время выполнения в миллисекундах (мс), свыше которого все операторы будут записываться в журнал.
По умолчанию значение параметра log_min_duration_statement равно -1, что отключает журнализацию операторов.
Установка параметра log_min_duration_statement в 0 приведет к записи операторов любой длительности выполнения.
Замечание. Установка этого параметра в рабочем окружении может привести к большим объемам журналов и значительному выделению дискового пространства.
Continue reading "Параметр log_min_duration_statement в PostgreSQL"