Контрольные точки, лавинная запись и вы
Автор: Shaun Thomas,Checkpoints, Write Storms, and You
Каждая база данных должна примириться с двумя неприятными истинами: память быстра, но энергозависима, а диск медленен, но долговечен. Postgres справляется с этим противоречием с помощью журнала предзаписи (Write-Ahead Log, WAL), который регистрирует каждое изменение до того, как оно произойдёт. Но WAL не может расти бесконечно. В какой-то момент Postgres должен сбросить все накопившиеся грязные страницы на диск и объявить чистую начальную точку. Этот процесс называется контрольной точкой (checkpoint), и когда он идёт не по плану, пропускная способность может упасть до нуля.
Немного о контрольных точках
При нормальной работе Postgres ведёт себя удивительно вежливо в отношении контрольных точек. Параметр checkpoint_timeout (по умолчанию 5 минут) указывает Postgres, как часто выполнять плановую контрольную точку, а checkpoint_completion_target (по умолчанию 0.9) указывает распределить результирующие записи на 90% этого интервала. Таким образом, тайм-аут контрольной точки в 5 минут означает, что Postgres «сочится» грязными страницами на диск в течение примерно 4.5 минут, сводя к минимуму влияние на ввод-вывод.
Это относится только к поведению плановых контрольных точек.
Параметр max_wal_size задаёт мягкий предел того, сколько WAL может накопиться между контрольными точками. Когда WAL приближается к этому порогу (по умолчанию 1 ГБ), Postgres не ждёт следующей плановой контрольной точки. Вместо этого он принудительно запускает её немедленно.
Эти принудительные (или запрошенные) контрольные точки не учитывают checkpoint_completion_target. Postgres необходимо освободить место в WAL, поэтому он сбрасывает каждый грязный буфер на диск так быстро, как только позволяет подсистема ввода-вывода. В загруженной системе с большим пулом shared_buffers, полным изменённых страниц, это может полностью насытить дисковый ввод-вывод за секунды.
Это как пытаться пить из пожарного шланга.
Переходим к делу
Чтобы увидеть это в действии, мы настроили скромную тестовую среду:
- Гипервизор: Proxmox
- ЦП: 4 ядра AMD EPYC 9454
- ОЗУ: 4 ГБ
- Хранилище для БД: 100 ГБ с 2000 операций ввода-вывода в секунду (IOPS)
- Хранилище для WAL: 100 ГБ с 2000 операций ввода-вывода в секунду
- ОС: Debian 12 Bookworm
Мы инициализировали базу данных с помощью pgbench с коэффициентом масштабирования 800, получив примерно 12 ГБ данных (в 3 раза больше доступной ОЗУ для уменьшения попаданий в кэш). Мы также последовали традиционному совету и установили shared_buffers в 25% от ОЗУ, или 1 ГБ в данном случае. Все остальные настройки остались по умолчанию.
Каждый тест следовал одному и тому же шаблону: выполнить ручную CHECKPOINT для чистой стартовой позиции, затем запустить pgbench на 60 секунд с посекундной отчётностью о прогрессе и 16 одновременными клиентами, чтобы занять все ядра ЦП:
pgbench --progress=1 --time=60 --clients=16 demoМы начали со значения max_wal_size по умолчанию (1 ГБ), чтобы увидеть, как ведёт себя система. Этот параметр часто упускают из виду при оптимизации, поэтому он должен послужить хорошим примером базовой работы.
Пропускная способность оставалась стабильной между 1000 и 1100 TPS (транзакций в секунду) в течение первых 41 секунды теста. Буферы начали прогреваться, подсистема ввода-вывода успевала, задержка оставалась низкой. На 42-й секунде объём вывода WAL достиг 1 ГБ, и Postgres принудительно запустил контрольную точку. TPS мгновенно упала примерно до 620 — падение почти на 40%! Она так и не восстановилась до конца теста.
Мы увеличили max_wal_size до 4 ГБ для второго теста. Это скромное увеличение, но достаточное для целей демонстрации. На этот раз пропускная способность начиналась с 1000 TPS и постепенно росла по мере прогрева буферов, достигнув 1200 TPS к концу теста. Одной минуты активности pgbench на этом оборудовании недостаточно для генерации 4 ГБ WAL, что означает отсутствие принудительной контрольной точки.
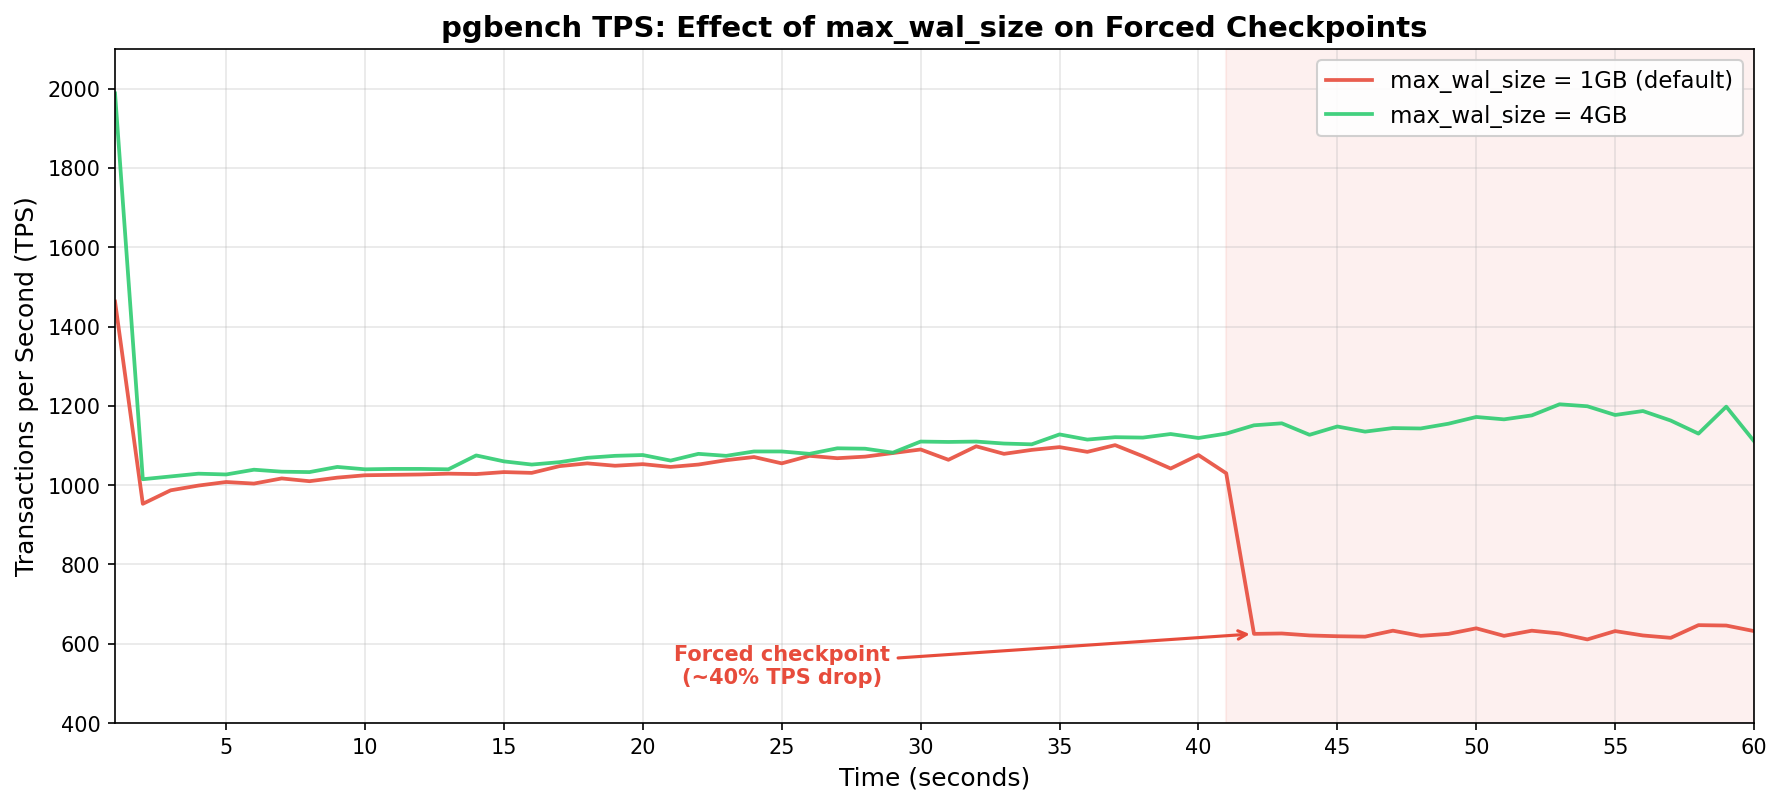
Результаты говорят сами за себя. Оба теста шли практически одинаково в течение первых 40 секунд. Затем конфигурация с 1 ГБ упёрлась в стену, в то время как конфигурация с 4 ГБ продолжала расти.
Цена принудительных контрольных точек
Обычно Postgres использует checkpoint_completion_target во время плановой контрольной точки для расчёта бюджета записи. Если между контрольными точками 5 минут, а целевое значение равно 0.9, он может распределить запись грязных страниц на 270 секунд. Это много времени для «сочащейся» записи на диск, и влияние на ввод-вывод в секунду минимально.
У принудительной контрольной точки нет такой роскоши. WAL заполнен (или почти заполнен), и Postgres нужно освободить место прямо сейчас. Он записывает грязные буферы так быстро, как может, конкурируя напрямую с активными запросами за дисковый ввод-вывод. Эта конкуренция становится ожесточённой в системе, ограниченной 2000 операций ввода-вывода в секунду. Каждая операция ввода-вывода, потраченная на сброс данных контрольной точки, фактически украдена у пользовательских запросов.
Серьёзность проблемы сильно зависит от оборудования. Системы с быстрым NVMe-хранилищем и десятками (или сотнями) тысяч операций ввода-вывода в секунду могут почти не заметить проблемы. Но облачные инстансы, виртуализированные среды или любые системы с ограничением операций ввода-вывода (что чрезвычайно распространено) почувствуют боль. Мы выделили нашей тестовой системе 2000 операций ввода-вывода в секунду на том, что является относительно щедрым по облачным меркам, и всё равно наблюдали заметное влияние.
Сам бенчмарк — это только половина истории. До этого нам пришлось инициализировать тестовую базу данных объёмом 12 ГБ с помощью pgbench --initialize. Пока pgbench генерировал тестовые данные со значением max_wal_size по умолчанию (1 ГБ), Postgres запустил 18 принудительных контрольных точек. При повторной попытке с max_wal_size, установленным в 20 ГБ, это число снизилось до нуля.
Ну и что? Это же просто инициализация, не так ли? Учтите, что этот же шаблон применим к любой операции массовой загрузки данных: импорту COPY, большим INSERT INTO ... SELECT, CREATE INDEX на больших таблицах, REINDEX или даже большим пакетам UPDATE. Если какая-либо из этих операций выполняется одновременно с производственной OLTP-нагрузкой, это 18 штормов ввода-вывода, конкурирующих с запросами приложения.
Задание ETL, которое загружает несколько гигабайт данных каждую ночь, может вызвать цепочку принудительных контрольных точек, которые повысят задержку для всех остальных запросов в системе. Сама массовая операция также замедлится, поскольку будет бороться с вводом-выводом своей собственной контрольной точки за пропускную способность диска.
Проигрывают все, когда контрольные точки не могут распределить активность записи.
Как обнаружить проблему
Postgres отслеживает статистику контрольных точек, и их проверка должна быть частью любого регулярного оценки состояния здоровья. Используемое системное представление зависит от версии Postgres.
В Postgres 17 и новее используйте pg_stat_checkpointer:
SELECT num_timed, num_requested, num_done,

       write_time, sync_time, buffers_written

  FROM pg_stat_checkpointer;
В более старых версиях та же информация находится в pg_stat_bgwriter:
SELECT checkpoints_timed, checkpoints_req,

       checkpoint_write_time, checkpoint_sync_time,

       buffers_checkpoint

  FROM pg_stat_bgwriter;
Критическое соотношение здесь — количество плановых (timed) против запрошенных (requested) контрольных точек. В хорошо настроенной системе num_requested (или checkpoints_req) должно быть близко к нулю по сравнению с num_timed. Если запрошенные контрольные точки составляют значительную долю от общего числа, значение max_wal_size слишком мало для текущей нагрузки записи, и производительность, вероятно, неоптимальна.
Также стоит следить за write_time и sync_time. Если sync_time постоянно высока, подсистема хранения с трудом справляется со сбросами контрольных точек, что дополнительно подтверждает узкое место ввода-вывода во время контрольных точек.
Что касается журналирования, мы настоятельно рекомендуем установить log_checkpoints = on, чтобы регистрировать активность контрольных точек:
log_checkpoints = onЭто заставляет Postgres регистрировать подробную информацию о каждой контрольной точке, такую как количество записанных буферов, время, затраченное включая синхронизацию, и другие полезные показатели. Когда эта настройка включена, журнал Postgres должен показывать активность контрольных точек, подобную этой:
LOG:  checkpoint starting: wal

LOG:  checkpoint complete: wrote 2069 buffers (1.6%), wrote 2 SLRU buffers;

      0 WAL file(s) added, 1 removed, 32 recycled; write=2.132 s, sync=0.092 s,

      total=2.282 s; sync files=35, longest=0.090 s, average=0.003 s;

      distance=553713 kB, estimate=553713 kB; lsn=6/FEBDB228,

      redo lsn=6/DFFFFC60

LOG:  checkpoints are occurring too frequently (2 seconds apart)

HINT:  Consider increasing the configuration parameter "max_wal_size".
Строка checkpoint starting: wal — это дымящийся пистолет. Она означает, что эта контрольная точка была принудительной, потому что WAL достиг предела, а не потому, что истёк тайм-аут. Плановая контрольная точка вместо этого показала бы checkpoint starting: time.
Это бесплатная криминалистическая информация. Накладные расходы на журналирование незначительны и обеспечивают чёткий след поведения контрольных точек. Это ещё одна из тех настроек, которая должна быть включена по умолчанию, и она включена по умолчанию начиная с Postgres 15. Тем, у кого старые кластеры, придётся включить её вручную.
Поиск правильного значения max_wal_size
Так должны ли все просто увеличить max_wal_size до какого-то огромного значения и забыть о нём? Не совсем. Есть компромиссы.
Большее значение max_wal_size позволяет накапливать больше WAL между контрольными точками, что означает, что больше данных придётся воспроизводить при аварийном восстановлении. Если Postgres аварийно завершится с 20 ГБ WAL для воспроизведения, запуск обязательно займёт больше времени, чем с 1 ГБ. Эта разница во времени восстановления обычно составляет всего несколько секунд, но о ней стоит знать.
Другое соображение — дисковое пространство. Файлы WAL потребляют место на диске, а max_wal_size — это мягкий предел. При высоких нагрузках записи WAL может временно превысить его. На томе WAL должно быть достаточно свободного места, чтобы выдержать всплески без полного исчерпания пространства. Это была бы гораздо более серьёзная проблема, чем медленные контрольные точки.
Разумной отправной точкой для OLTP-нагрузок с интенсивной записью является 10–20 ГБ. Системы с агрессивной пакетной загрузкой или большими пакетными операциями могут выиграть от 50 ГБ или более. Цель состоит в том, чтобы сделать принудительные контрольные точки настолько редкими, чтобы по сути все контрольные точки были плановыми и распределялись плавно в соответствии с checkpoint_completion_target.
Мы рекомендуем проверить настройку, отслеживая pg_stat_checkpointer (или pg_stat_bgwriter) с течением времени. Дайте системе поработать в течение дня или недели в условиях типичной нагрузки, затем проверьте соотношение. Если количество запрошенных контрольных точек увеличилось, увеличьте max_wal_size и повторите.
-- Сброс статистики и повторная проверка после вашего периода наблюдения

SELECT pg_stat_reset_shared('checkpointer');


-- ... некоторое время спустя ...

SELECT num_timed, num_requested FROM pg_stat_checkpointer;
Если вы предпочитаете не делать это самостоятельно, я на самом деле написал расширение для Postgres под названием pg_walsizer. Оно запускает фоновый рабочий процесс, который отслеживает активность контрольных точек и автоматически увеличивает max_wal_size в зависимости от того, сколько контрольных точек происходит в пределах настроенного checkpoint_timeout. Просто установите и забудьте!
Завершение
Контрольные точки — это одна из внутренних механик Postgres, о которой большинство людей никогда не задумываются, пока что-то не пойдёт не так. Периодические скачки задержки в конце концов могут иметь множество причин. Не все администраторы баз данных проверяют активность WAL или осознают её связь со сбросами на диск — большинство сначала винит очистку (vacuum).
Как это принято, значение по умолчанию для max_wal_size (1 ГБ) является консервативным. Оно минимизирует время аварийного восстановления и хорошо работает для лёгких нагрузок без использования большого объёма хранилища. К сожалению, загруженные системы быстро превысят это значение по умолчанию и начнут страдать. Наш тест показал падение TPS на 40% на скромном оборудовании; производственные системы с более высокими нагрузками и более жёсткими бюджетами ввода-вывода, вероятно, пострадают ещё больше.
Для большинства производственных сред мы предлагаем начинать с более подходящего значения max_wal_size. Если log_checkpoints ещё не включён, включите его в первую очередь. И, наконец, либо pg_stat_checkpointer, либо pg_stat_bgwriter должны быть видны на панели мониторинга. Относитесь с подозрением к любому увеличению количества запрошенных контрольных точек.
В конечном счёте, max_wal_size — это один из тех редких случаев, когда один параметр может дать существенное улучшение практически без недостатков. Так что идите и проверьте свою статистику контрольных точек. Вы можете удивиться тому, что найдёте!
Trackbacks
The author does not allow comments to this entry
Comments
Display comments as Linear | Threaded